Meszéna Balázs cikke
Mit tanulhat a mesterséges intelligencia az agytól, és hogyan segíthetnek a generatív MI-modellek megérteni az idegsejtek működését? A vizuális észlelés példáján keresztül a két kutatási irány találkozását mutatjuk be.
A mesterséges intelligencia az elmúlt másfél évtizedben rendkívüli fejlődésen ment keresztül: alkalmazásai a mindennapi élet és a tudományos kutatás részévé váltak. Bizonyos képességek azonban továbbra is kihívást jelentenek. Egy MI-rendszernek nemcsak helyes választ kell adnia, hanem azt is fel kell ismernie, mikor bizonytalan. Nehezen kezeli, ha a valódi környezet eltér a tanítás során látott adatoktól (adateloszlás-eltolódás), és egy új feladat elsajátítása ronthatja a korábban megtanult feladatokon nyújtott teljesítményét (katasztrofális felejtés). Az ember és más állatok ezzel szemben sok helyzetben kevés tapasztalatból is rugalmasan alkalmazkodnak.
E problémák vizsgálatának egyik útja, amikor a gépi tanulás az idegtudományból merít ötleteket. Az együttműködés ugyanakkor kétirányú: a modern MI-modellek eszközt adhatnak az agyi aktivitás értelmezéséhez és az idegrendszer számítási elveinek feltárásához.
A gépi és a biológiai látás kapcsolata
A látórendszer hierarchikusan szerveződik. A retinából érkező információ az elsődleges látókéregbe (V1), majd többek között a V2, V4 és az IT felé halad. A feldolgozás korai szintjein egyszerűbb tulajdonságok, például az élek iránya, magasabb szinteken összetettebb mintázatok és objektumok kapnak hangsúlyt. A képfelismerésre tanított mély neurális hálók rétegei meglepően jól jósolják meg a látórendszer különböző területeinek idegi válaszait [1].
A szokásos képfelismerő hálókban az információ azonban elsősorban egy irányba, az úgynevezett bottom-up vagy előrecsatolt útvonalon terjed. Ezzel szemben a biológiai látórendszerben bőségesen találunk top-down, vagyis magasabb területekről visszafelé irányuló kapcsolatokat is. Ezeken keresztül a magasabb szintek „visszaszólhatnak” az alacsonyabbaknak: a már kialakuló értelmezésnek megfelelő jelzést küldenek, amely befolyásolja, hogyan dolgozzák fel a korai területek a beérkező jelet. A látás így nem egyirányú folyamat, hanem az érzékszervi adatok és a várakozások folyamatos egyeztetése. Ezek a kapcsolatok különösen fontosak lehetnek gyenge vagy többértelmű érzékszervi információ esetén: félhomályban, ködben vagy részben takart tárgyaknál az észlelésünket a világról tanult ismereteink is alakítják.
Az észlelés, mint valószínűségi következtetés
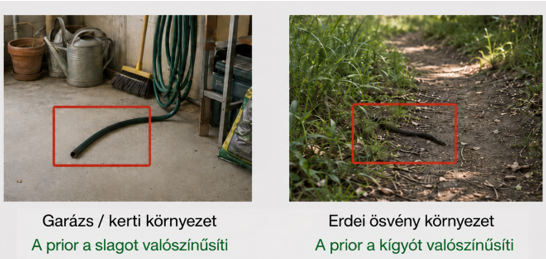
Képzeljünk el egy földön heverő sötét, ívelt tárgyat. A garázsban valószínűleg kerti slagként, egy erdei ösvényen inkább kígyóként értelmeznénk. A lokális képi információ hasonló lehet, mégis más magyarázatot tartunk valószínűnek. A különbség az előzetes tudásunkban, a priorban rejlik: abban, hogy az adott környezetben mit várunk.
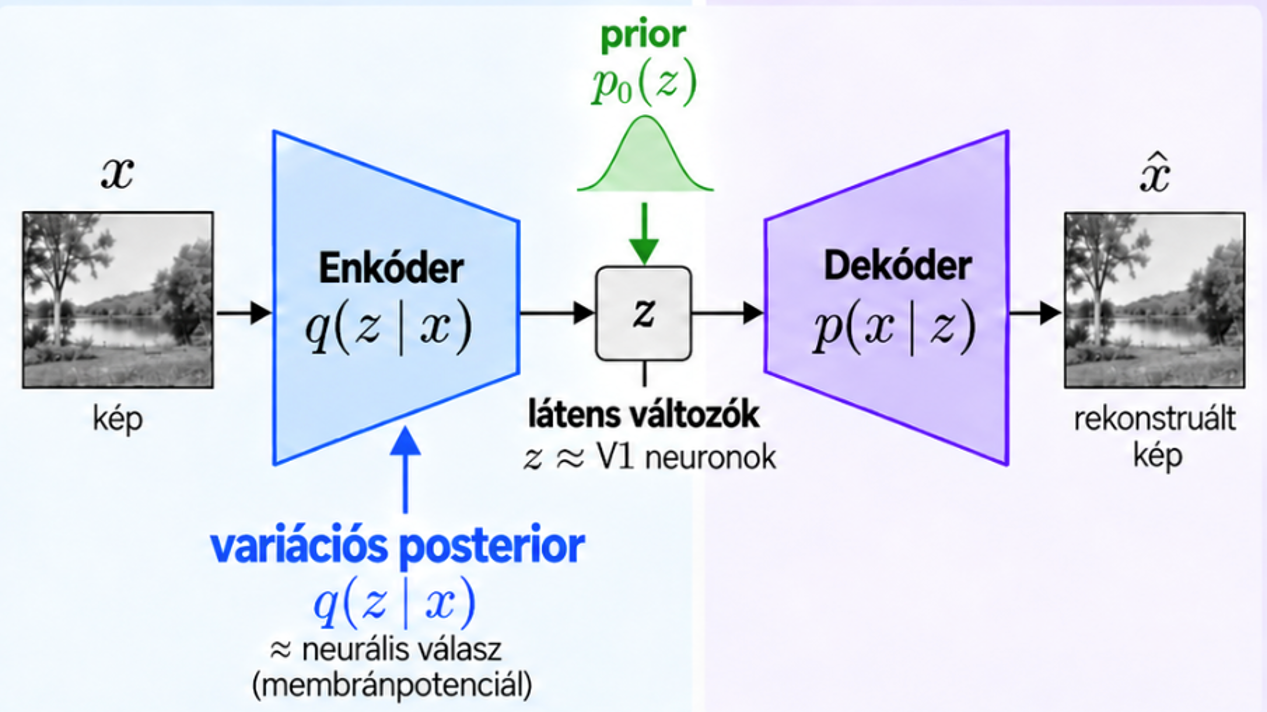
A látens generatív modellek ezt a gondolatot matematikai formába öntik. Feltételezik, hogy a megfigyelt kép (x) rejtett okokból vagy tulajdonságokból (z) keletkezik: ilyen lehet egy él orientációja, egy textúra vary egy objektum jelenléte. A modell leírja, mely tulajdonság-együttesek mennyire valószínűek (prior), és milyen képet várnánk tőlük. Az észlelés során a képből származó evidenciát és az előzetes várakozást kombináljuk, Bayes szabályának megfelelően; az eredmény a rejtett okokra vonatkozó utólagos, úgynevezett posterior eloszlás:
p(z | x) ∝ p(x | z) · p(z)
A mélytanulás lehetővé tette, hogy az ilyen modelleket összetett képi adatokra is alkalmazzuk. A variációs autoenkóder (VAE) két neurális hálót tanít: az enkóder a képből megbecsüli a látens tulajdonságok valószínűségi eloszlását, a dekóder pedig a látens változókból képet tud előállítani. A dekóder tehát a világ egyszerűsített belső modelljét, egyfajta világmodellt testesít meg: azt írja le, hogyan jönnek létre a képek a rejtett okokból. Az enkóder ezt a modellt „fordítja meg”: egy konkrét képből következtet arra, milyen rejtett okok állhatnak mögötte. A modell látens egységeinek válaszai így az idegi aktivitás lehetséges számítási megfelelőiként vizsgálhatók [2]: egy-egy látens egységet egy-egy látókérgi idegsejtnek feleltetünk meg, és azt vizsgáljuk, mennyire hasonlít a modell következtetése a mért idegi válaszokra.
Tudja-e a modell, mennyire bizonytalan?
A prior és a szenzoros evidencia megfelelő egyesítéséhez a bizonytalanságot is reprezentálni kell. Jó látási viszonyok között a képi információnak kell dominálnia; homályos vagy zajos képnél a priornak nagyobb szerephez kell jutnia. Bár a VAE eleve valószínűségi modell, ez önmagában nem garantál jól kalibrált bizonytalanságbecslést. Megfigyeltük, hogy egy standard VAE-alapú látókéreg-modellben a látens válaszok bizonytalansága a kép kontrasztjának csökkenésével alig nőtt, szemben az idegi adatok által sugallt viselkedéssel.
A biológiai látás és a természetes képek statisztikája által inspirált Explaining-Away VAE (EA-VAE) egy további, globális skálaváltozót vezet be. Ez lehetővé teszi, hogy a modell jobban különválassza a kontraszt változását a kép tartalmát meghatározó látens tényezőktől. A módosítás a bizonytalanság becslését nemcsak alacsony kontrasztnál, hanem különféle képromlások és a tanítási adatoktól eltérő minták esetében is javította, többek között orvosi képadatokon [3]. A megbízható bizonytalanságbecslés a gépi látás egyik általános kihívása: egy önvezető autónak vagy egy orvosi diagnosztikai rendszernek is fel kell ismernie, ha a bemenet eltér attól, amit a tanítás során látott. Itt tehát az idegtudományi inspiráció egy általános gépi látási problémára kínált megoldást, amelyet elméleti garanciák is alátámasztanak.
Hierarchikus világmodell és az illuzórikus kontúr
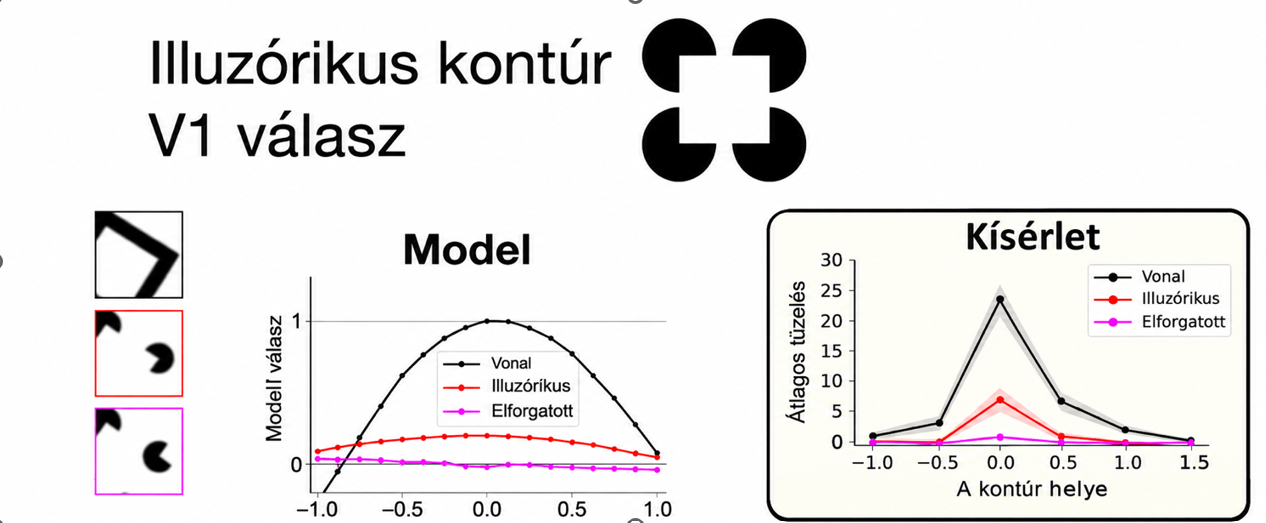
A következő lépésben azt vizsgáltuk, mi történik, ha a világmodell – a látórendszerhez hasonlóan – több, egymásra épülő szintből áll, és a magasabb szintek top-down módon befolyásolják az alacsonyabbakat. A top-down hatások vizsgálatához olyan hierarchikus modellt építettünk, amelynek alsó látens szintje a V1-hez, felső szintje a V2-höz hasonló tulajdonságokat tanul. A természetes képeken tanított TDVAE-modell alsó szintjén lokális, irányérzékeny szűrők, a felsőn összetettebb textúrajellemzők jelennek meg, anélkül hogy ezeket a tulajdonságokat kézzel írtuk volna elő. A modell a magasabb szint információját visszacsatolja az alacsonyabb szintű következtetésbe, és számos ismert idegtudományi jelenséget képes megmagyarázni [4].
Különösen szemléletes példa a Kanizsa-illúzió. Négy, megfelelően elhelyezett, körcikk alakú bevágással ellátott fekete korongot látva fehér négyzet körvonalát érzékeljük, jóllehet a négyzet élei fizikailag nincsenek kirajzolva. Főemlősök látókérgében olyan idegsejtek is aktiválódnak, amelyek receptív mezejében nincs tényleges él, de az illuzórikus kontúr áthalad rajta [5]. A TDVAE-ben hasonló válaszok jelennek meg, míg az illúziót megszüntető, elforgatott kontrollmintázatok jóval gyengébb választ váltanak ki. A modellben végzett beavatkozások szerint ehhez lényegesen hozzájárul a felső szintről érkező információ [4].
Nemcsak a látvány, a feladat is alakítja a priort
A természetes képek megtanult szabályszerűségei viszonylag általánosak. A konkrét viselkedési feladat azonban új, gyorsan változó várakozásokat is kialakíthat. Ezt vizsgáltuk a Rutgers Egyetem kutatóival közösen, egereken végzett vizuális diszkriminációs kísérletek és egy új generatív modell segítségével [6, 7].
Az állatoknak csíkozott minták irányát kellett megkülönböztetniük. Egy 45 fokos mintára nyalással kellett válaszolniuk (Go), míg egy 135 fokos mintánál vissza kellett tartaniuk a választ (NoGo). A betanulás után hat vizsgálati alkalmon a Go-inger változatlan maradt, a NoGo-inger szöge viszont fokozatosan közeledett hozzá: 135°, majd 90°, 75°, 70°, 65° és 60°. Közben kétfotonos kalciumképalkotással – egy mikroszkópos módszerrel, amely az idegsejtek aktivitását fluoreszcens fényjelként teszi láthatóvá – követték az elsődleges látókéreg sok ezer idegsejtjének aktivitását; az eredményeket feladatra nem tanított (naiv) állatokéval is összevetették.
A kérdés az volt: hogyan tud egy már kialakult látórendszer új feladathoz alkalmazkodni anélkül, hogy eldobná a hosszú idő alatt megszerzett tudását? A természetes képeken korábban betanított VAE teljes újratanítása számításigényes, kevés feladatspecifikus adat esetén nem megbízható, és a korábbi képességeket is károsíthatja. Az agy esetében sem életszerű azt feltételezni, hogy minden új feladatnál a teljes látókéreg újratanulja a természetes képek statisztikáját.
TAVAE: adaptáció a prior megváltoztatásával
Erre dolgoztuk ki a Task-Amortized VAE (TAVAE) módszert [7]. Ebben a modell „látását” – a természetes képeken megtanult világmodellt és az enkódert – változatlanul hagyjuk, és az új feladathoz csak a várakozásokat, vagyis a priort cseréljük le. Ez ahhoz hasonlít, mint amikor a garázsból az erdőbe lépünk: a szemünk és a látórendszerünk ugyanaz marad, csak az változik, mire számítunk. Az egérkísérletben az új prior például azt rögzíti, hogy a feladatban jellemzően csak néhány csíkirány fordul elő. Az új következtetést ezután nem kell elölről kiszámolni: elég a modell eredeti válaszát a régi és az új várakozás arányával korrigálni. Képlettel:
qₜ(z | x) ∝ q₀(z | x) · pₜ(z) / p₀(z)
Itt q₀ a modell eredeti következtetése, p₀ a természetes képekhez tartozó régi, pₜ a feladathoz tanult új várakozás, qₜ pedig az eredmény. Azokat az értelmezéseket, amelyek az új feladatban gyakoribbak, a modell felerősíti, a ritkábbakat pedig elnyomja. A hálózat korábban megtanult paramétereit (súlyait) tehát nem kell minden feladatváltásnál módosítani; elég egy kicsi, gyorsan megtanulható „várakozás-modult” cserélni. Ezért a módszer kevés adatból is működik, és nem rontja el a korábban megszerzett tudást.
Idegi mérések feladatot teljesítő állatban
A legfontosabb eredmény, hogy a feladatból tanult várakozások már a legkorábbi látókérgi területen, a V1-ben is megváltoztatják, hogyan reprezentálódik ugyanaz a kép. Amikor az egerek olyan irányú csíkozást láttak, amellyel a betanulás során nem találkoztak, a V1 populációs aktivitása jelentősen eltért a feladatra nem tanított állatokétól. A naiv állatoknál a látókéreg hűen tükrözte a látottakat: a legerősebben azok az idegsejtek válaszoltak, amelyek éppen a bemutatott irányt kedvelik. A tanított állatoknál ezzel szemben a válasz a feladatból ismert irányok felé tolódhatott, sőt bizonyos helyzetekben két csúcs jelent meg, miközben éppen a ténylegesen látott irány maradt alulreprezentálva.
Ez a kétcsúcsú válasz különösen árulkodó. A TAVAE szerint ilyenkor a bizonytalan érzékszervi jel a feladatból tanult várakozással egyesül. Amikor a kettő nem illik össze, a modell válaszában több, egymással versengő értelmezés nyoma jelenhet meg.
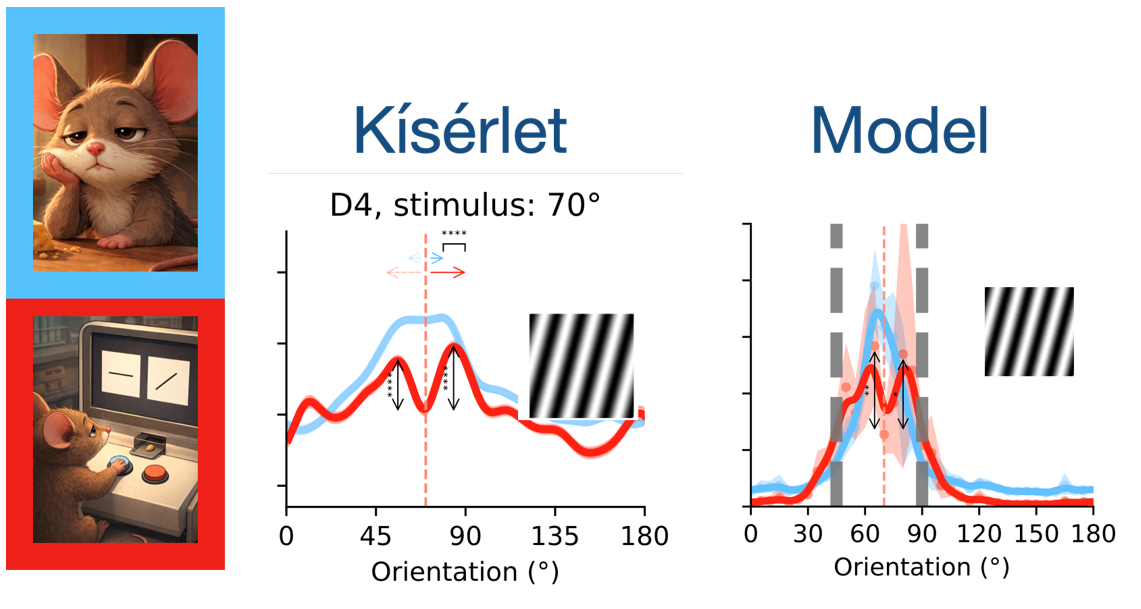
A modell tehát magyarázatot kínál arra, hogy a várakozások miként torzíthatják szisztematikusan még a korai látókérgi reprezentációkat is. Amit látunk, tehát nemcsak a szemünkbe jutó fénytől függ, hanem attól is, mire számítunk, és ez a hatás már a feldolgozás legelső kérgi lépésében megjelenik.
Összegzés
A fenti három példa közös tanulsága az idegtudomány és a mesterséges intelligencia közötti kétirányú kapcsolat. Egyrészt a biológiai látás működése ötleteket ad – ahogy az EA-VAE példája mutatja – a robusztusabb, bizonytalanságot kezelő és gyorsan alkalmazkodó MI-rendszerekhez. Másrészt a generatív MI-modellek – mint a TDVAE és a TAVAE – kísérletileg vizsgálható állításokat fogalmaznak meg az idegi aktivitásról: arról, hogyan egyesülnek az érzékszervi adatok a tanult világmodellel és a pillanatnyi feladattal. A cél a neuronok válaszainak előrejelzése, illetve annak megértése, milyen számításokat végezhet az agy, amikor értelmet ad a látottaknak.